మీరు ఒక ఛార్జీని వ్యతిరేకించడానికి రాత్రి 9 గంటలకు మీ బ్యాంకుకు ఫోన్ చేస్తారు. ఒక వాయిస్ ఫోన్ ఎత్తి, మొదటి ప్రయత్నంలోనే సమస్యను అర్థం చేసుకుని, లావాదేవీని చూసి, మీ గుర్తింపును నిర్ధారించి, దాన్ని పరిష్కరిస్తుంది — హోల్డ్ మ్యూజిక్ లేదు, బదిలీ లేదు, "ప్రధాన మెనూకు తిరిగి వెళ్లడానికి 4 నొక్కండి" అనే సూచన కూడా లేదు. ఆ సంభాషణ AI సాధించిన ఒక గొప్ప విజయంలా అనిపిస్తుంది.

అవును. కానీ చాలా మంది అనుకునే విధంగా కాదు. ఆ మోడల్ ఇప్పుడు చాలా వరకు ఒక సాధారణ వస్తువుగా మారింది. ఆ నిర్ణయం విజయవంతం కావడానికి కారణం, మీలాగే మాట్లాడే వ్యక్తుల నుండి రికార్డ్ చేయబడిన వేలాది గంటల సంభాషణలు. "ఆరోపణను వివాదించడం" అంటే ఏమిటో అంగీకరించిన వ్యాఖ్యాతలు వాటికి లేబుల్స్ వేశారు, సిస్టమ్ నిజంగా వినగలిగే యాసలు మరియు పదబంధాల కోసం వాటిని వడపోశారు, మరియు ఎవరి అనుమతి లేకుండా వారి గొంతు శిక్షణా సమితిలోకి చేరకుండా నియంత్రించారు.
2026లో సంభాషణాత్మక AI యొక్క అసలు కథ ఇదే. ఈ మార్కెట్ సుమారుగా 21% CAGRతో $82.46 బిలియన్ల వైపు దూసుకుపోతోంది , ప్రస్తుతం 78% సంస్థలు కనీసం ఒక వ్యాపార విధిలోనైనా AIని ఉపయోగిస్తున్నాయి, మరియు 75% సంస్థలు కస్టమర్ సపోర్ట్ కోసం పెద్ద భాషా నమూనాలను అమలు చేయడానికి సిద్ధంగా ఉన్నాయి. ఈ టెక్నాలజీ స్థిరపడిపోయింది. ప్రత్యేకత ఇప్పుడు డేటా వైపుకు మారింది. ఇదంతా ఎలా కలిసిపోతుందో ఇక్కడ చూడండి.
సంభాషణాత్మక AI అంటే ఏమిటి
సంభాషణాత్మక AI అనేది చాట్బాట్లు, వర్చువల్ ఏజెంట్లు, వాయిస్ అసిస్టెంట్లు వంటి వ్యవస్థల సమూహం. ఇవి సహజమైన, పరస్పర సంభాషణను కొనసాగించడానికి ప్రసంగ గుర్తింపు, సహజ భాషా అవగాహన మరియు ప్రసంగ ఉత్పత్తిని మిళితం చేస్తాయి, మరియు వీటిని ఉపయోగించిన ప్రతిసారీ మరింత మెరుగవుతాయి.
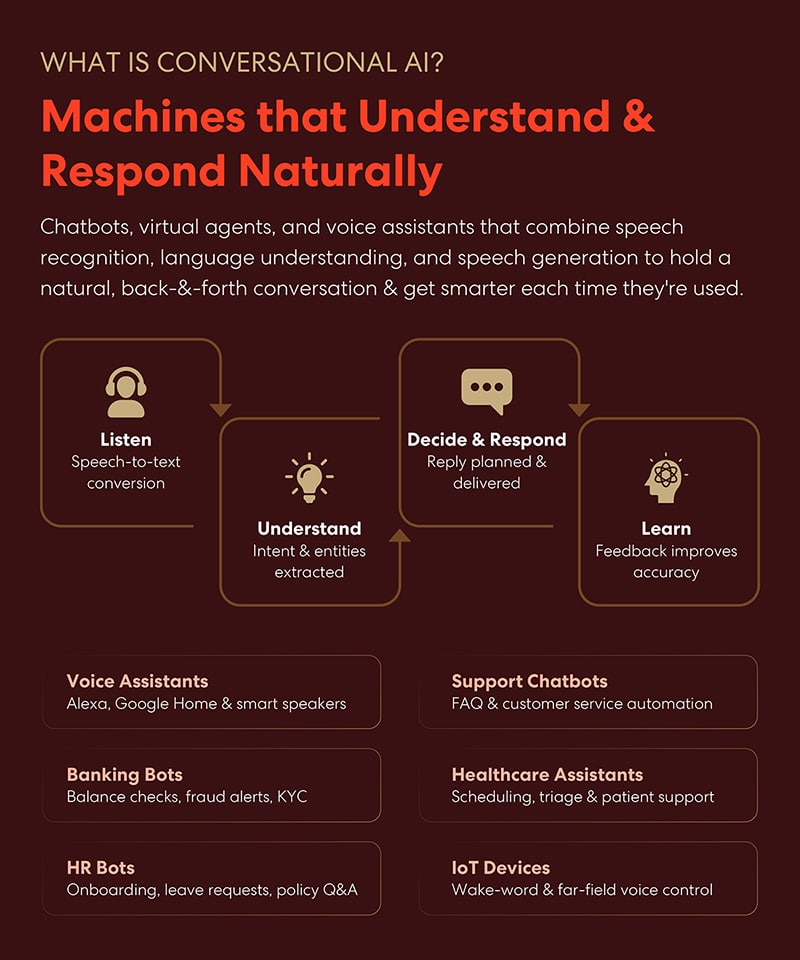
ఈ వైవిధ్యం వెనుక, అవన్నీ ఒకే నాలుగు-దశల లూప్ను అనుసరిస్తాయి.
- వ్యవస్థ ఇటువంటి మాటలుప్రసంగాన్ని టెక్స్ట్గా మార్చడం.
- It అర్థం, ఉద్దేశం మరియు అంశాలను సంగ్రహించడం — వినియోగదారుడు ఏమి కోరుకుంటున్నాడు, మరియు ఆ కోరికకు జోడించబడిన నిర్దిష్ట వివరాలు.
- It నిర్ణయించి ప్రతిస్పందిస్తుందిప్రత్యుత్తరాన్ని ప్రణాళిక చేసి, దాన్ని అందించడం.
- మరియు ఇది తెలుసుకుంటుందితదుపరి మలుపులో మరియు తదుపరి వినియోగదారు వద్ద ఖచ్చితత్వాన్ని మెరుగుపరచడానికి ఫీడ్బ్యాక్ సంకేతాలను ఉపయోగించడం.
వినండి → అర్థం చేసుకోండి → నిర్ణయించుకోండి → నేర్చుకోండి. కింద ఉన్న ప్రతి ఉత్పత్తి కూడా ఇదే వలయంలో ఇమిడి ఉన్న ఒక విభిన్నమైన రంగం.
- వాయిస్ అసిస్టెంట్లు అలెక్సా మరియు గూగుల్ హోమ్ లాగా, ఇవి స్మార్ట్ స్పీకర్ల ద్వారా అపరిమితమైన గృహ అభ్యర్థనలను నిర్వహిస్తాయి.
- చాట్బాట్లకు మద్దతు ఇవ్వండి FAQ నిర్వహణ మరియు కస్టమర్ సర్వీస్ ట్రైయేజ్ను స్వయంచాలకం చేయండి.
- బ్యాంకింగ్ బాట్లు బ్యాలెన్స్ తనిఖీలు, మోస హెచ్చరికలు మరియు KYC ధృవీకరణను నిర్వహించండి.
- ఆరోగ్య సంరక్షణ సహాయకులు షెడ్యూలింగ్, లక్షణాల వర్గీకరణ మరియు రోగికి మద్దతును నిర్వహించడం.
- హెచ్ఆర్ బాట్లు క్షేత్రస్థాయి ఆన్బోర్డింగ్ ప్రశ్నలు, సెలవు అభ్యర్థనలు మరియు పాలసీ ప్రశ్నోత్తరాలు.
- మరియు IOT పరికరాలు వేక్-వర్డ్ డిటెక్షన్ మరియు ఫార్-ఫీల్డ్ వాయిస్ కంట్రోల్పై ఆధారపడతాయి, ఇక్కడ మైక్రోఫోన్ గదికి అవతలి వైపు ఉంటుంది మరియు వినియోగదారుడు స్క్రీన్ను చూస్తూ ఉండడు.
పైప్లైన్ ఒకటే, కానీ వైఫల్య పరిస్థితులు పూర్తిగా భిన్నమైనవి. ఉద్దేశాన్ని తప్పుగా అర్థం చేసుకునే రిటైల్ చాట్బాట్ ఒక కన్వర్షన్ను కోల్పోయేలా చేస్తుంది. ఉద్దేశాన్ని తప్పుగా అర్థం చేసుకునే హెల్త్కేర్ ట్రయేజ్ అసిస్టెంట్ రోగి భద్రతకు సంబంధించిన సంఘటనగా మారుతుంది. ఆ తేడా ఆర్కిటెక్చర్లో కాకుండా, డేటాలోనే తేలుతుంది.
ముడి ప్రసంగం శిక్షణ డేటాగా ఎలా మారుతుంది
రికార్డింగ్ నుండి మోడల్కు సిద్ధంగా ఉన్న డేటాసెట్ను తయారు చేయడానికి రెండు విభిన్న దశలు అవసరం: ప్రసంగాన్ని ఎలా సేకరించాలో ఎంచుకోవడం, ఆపై మోడల్ దాని నుండి నేర్చుకునేలా లేబుల్ చేయడం. వీటిని ఒకే దశగా పరిగణించే బృందాలు, చివరికి తప్పుడు విషయాలను బోధించే ఒక పెద్ద డేటాసెట్తో మిగిలిపోయే అవకాశం ఉంది.
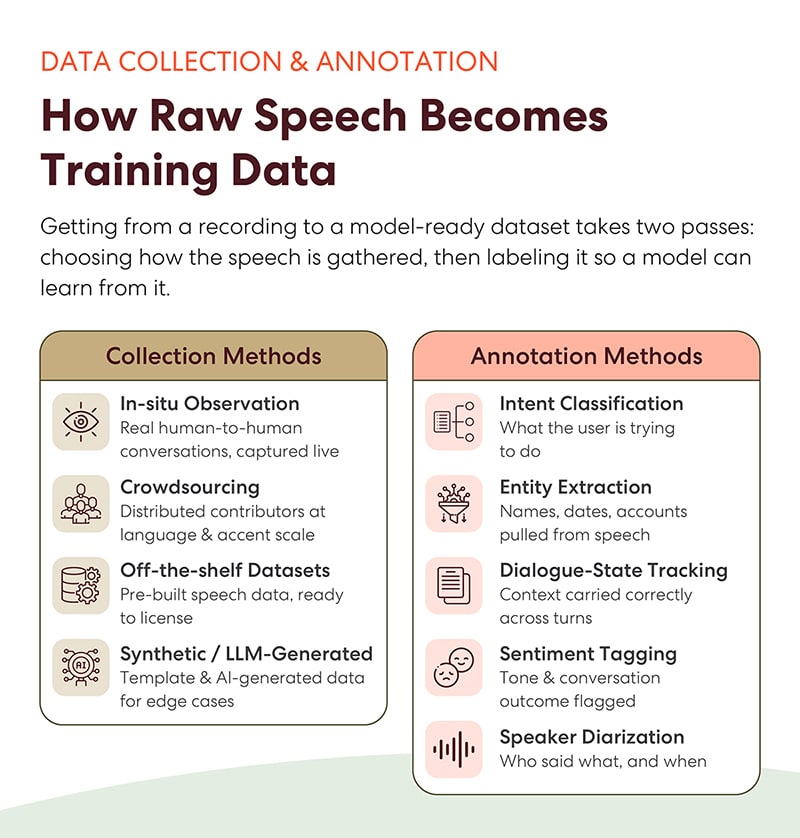
సేకరణ విషయంలో , నాలుగు పద్ధతులు చాలా అవసరాలను తీరుస్తాయి.
- క్షేత్రస్థాయి పరిశీలన నిజమైన మానవ సంభాషణలను ప్రత్యక్షంగా చిత్రీకరిస్తుంది — ఇది అందుబాటులో ఉన్న అత్యంత విశ్వసనీయమైన సంకేతం, మరియు పెద్ద ఎత్తున పొందడం అత్యంత కష్టం.
- క్రౌడ్ సోర్సింగ్ భాష మరియు యాస ఆధారంగా ఎంపిక చేయబడిన సహకారులకు రికార్డింగ్ను పంపిణీ చేస్తుంది, ఈ విధంగానే కవరేజ్ అనుకోకుండా కాకుండా ఉద్దేశపూర్వకంగా నిర్మించబడుతుంది.
- ఆఫ్-ది-షెల్ఫ్ డేటాసెట్లు డొమైన్ సముచితంగా సరిపోలినప్పుడు, లైసెన్సు ఇవ్వడానికి సిద్ధంగా ఉన్న, ముందుగా నిర్మించిన, ఆమోదించబడిన ప్రసంగ డేటాను అందించడం ద్వారా కాలపరిమితిలో నెలల సమయాన్ని తగ్గించవచ్చు.
- మరియు సింథటిక్ లేదా LLM-ఉత్పత్తి చేయబడిన వేచి ఉండలేనంత అరుదైన ప్రత్యేక సందర్భాల కోసం, టెంప్లేట్ ఆధారిత మరియు AI- రూపొందించిన ఉచ్చారణల వంటి నిర్దిష్ట లోపాలను డేటా పూరిస్తుంది.
అనోటేషన్ వైపు, ఐదు లేబులింగ్ పొరలు ఆడియోను పర్యవేక్షణగా మారుస్తాయి.
- ఉద్దేశ్య వర్గీకరణ వినియోగదారుడు ఏమి చేయడానికి ప్రయత్నిస్తున్నాడో ట్యాగ్ చేస్తుంది.
- ఎంటిటీ వెలికితీత ప్రసంగం నుండి పేర్లు, తేదీలు మరియు ఖాతా సంఖ్యలను బయటకు తీస్తుంది.
- సంభాషణ-స్థితి ట్రాకింగ్ ఇది మలుపుల మధ్య సందర్భాన్ని కొనసాగిస్తుంది, కాబట్టి "రెండవది" అనేది నాలుగు మలుపుల క్రితం ప్రస్తావించిన దాన్ని సూచిస్తుందని సిస్టమ్కు తెలుసు.
- సెంటిమెంట్ ట్యాగింగ్ ధోరణి మరియు సంభాషణ ఫలితాన్ని సూచిస్తుంది.
- మరియు స్పీకర్ డైరైజేషన్ ఎవరు ఏమి, ఎప్పుడు చెప్పారో ఇది నిర్ధారిస్తుంది — ఇది ఏ బహుళ-పక్ష రికార్డింగ్కైనా, అంటే చాలా వరకు నిజమైన కాల్ డేటాకైనా, రాజీపడలేని విషయం.
సేకరించండి → లిప్యంతరీకరించండి → ఉద్దేశ్యాలు మరియు ఎంటిటీలకు లేబుల్ చేయండి → స్థితిని ట్రాక్ చేయండి → డైరీలో నమోదు చేయండి → ధృవీకరించండి. ఒక దశను దాటవేస్తే, అనర్గళంగా లిప్యంతరీకరించే కానీ ఏమీ అర్థం చేసుకోలేని మోడల్ మీకు లభిస్తుంది.
“మంచి డేటా”ను వాస్తవానికి దేని ద్వారా కొలుస్తారు
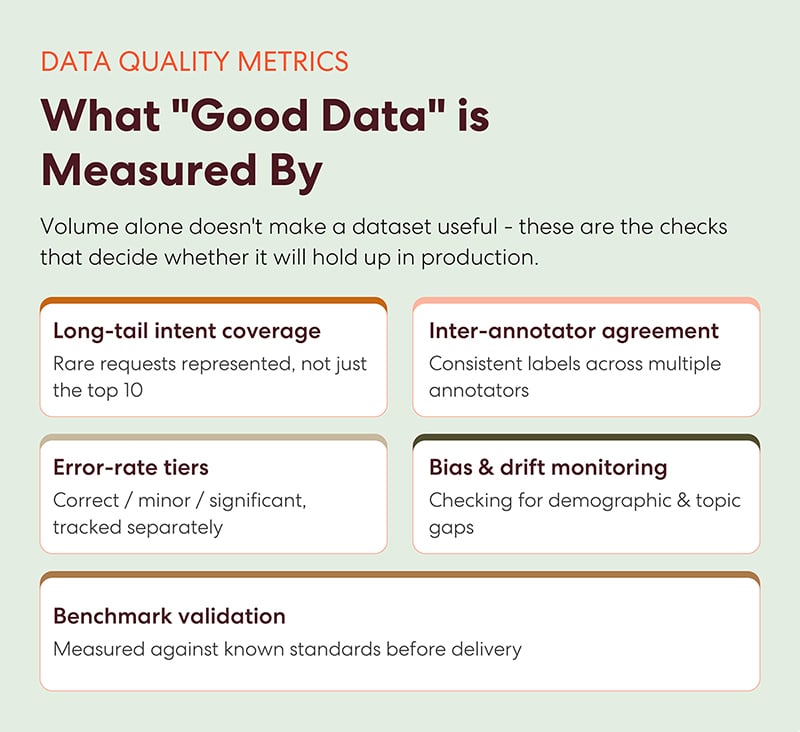
కేవలం పరిమాణం మాత్రమే ఒక డేటాసెట్ను ఉపయోగకరంగా మార్చదు. అది ఉత్పత్తిలో నిలబడుతుందా లేదా అని ఐదు తనిఖీలు నిర్ణయిస్తాయి, మరియు వాటి గురించి ఏ విక్రేతను అయినా నేరుగా అడగడం మంచిది.
- లాంగ్-టెయిల్ ఇంటెంట్ కవరేజ్ కేవలం మొదటి పది మాత్రమే కాకుండా, అరుదైన అభ్యర్థనలు కూడా ఉన్నాయా అని ఇది అడుగుతుంది. చాలా డేటాసెట్లలో వినియోగదారులు నిరంతరం ఉపయోగించే కొన్ని ఇంటెంట్లే ఆధిపత్యం చెలాయిస్తాయి — మరియు చాలా ఉత్పత్తి వైఫల్యాలు చివరి భాగంలోనే జరుగుతాయి.
- వ్యాఖ్యాతల మధ్య ఒప్పందం పలువురు వ్యాఖ్యాతలు ఒకే వాక్యాన్ని ఒకే విధంగా లేబుల్ చేశారా లేదా అని ఇది కొలుస్తుంది; ఏకీభావం తక్కువగా ఉంటే, మీ లేబుల్లు అసలు వాస్తవానికి బదులుగా గందరగోళాన్ని సూచిస్తున్నాయని అర్థం.
- లోప-రేటు శ్రేణులు సరైన, చిన్న, మరియు ముఖ్యమైన తప్పులను వేరు చేసి, వాటిని స్వతంత్రంగా ట్రాక్ చేయండి, ఎందుకంటే విపత్కరమైన తప్పుడు వర్గీకరణలతో కూడిన 3% దోషాల రేటు, అల్పమైన తప్పుల 3% రేటుతో సమానం కాదు.
- పక్షపాతం మరియు డ్రిఫ్ట్ పర్యవేక్షణ జనాభా మరియు అంశాల పరమైన అంతరాలను తనిఖీ చేస్తుంది, మరియు భాష, వినియోగదారు ప్రవర్తన మారేకొద్దీ కాలక్రమేణా వాటిని గమనిస్తుంది.
- మరియు బెంచ్మార్క్ ధ్రువీకరణ డెలివరీకి ముందు డేటాసెట్ను తెలిసిన ప్రమాణాలతో సరిపోల్చి కొలుస్తుంది, కాబట్టి అది మీకు సమస్యగా మారకముందే నాణ్యత నిర్ధారించబడుతుంది.
మీరు అమలు చేయగల డేటాసెట్కి మరియు మీరు మళ్లీ చేయవలసిన డేటాసెట్కి మధ్య ఉన్న వ్యత్యాసం ఈ ఐదు అంశాలే.
విశ్వాసం అనేది డేటా లేయర్లో అంతర్నిర్మితంగా ఉంటుంది, దానికి అదనంగా జోడించబడదు.
స్పీచ్ డేటాలో ఒక వ్యక్తి యొక్క స్వరం మరియు మాటలు ఉంటాయి — ఇవి వారిని గుర్తించడానికి అత్యంత ముఖ్యమైన రెండు అంశాలు. డేటాను సేకరించినప్పటి నుంచే పాలనను రూపొందించాలి, ఎందుకంటే మీరు ఇప్పటికే శిక్షణ పొందిన రికార్డింగ్కు తర్వాత అంగీకారాన్ని జోడించడానికి మార్గం లేదు.
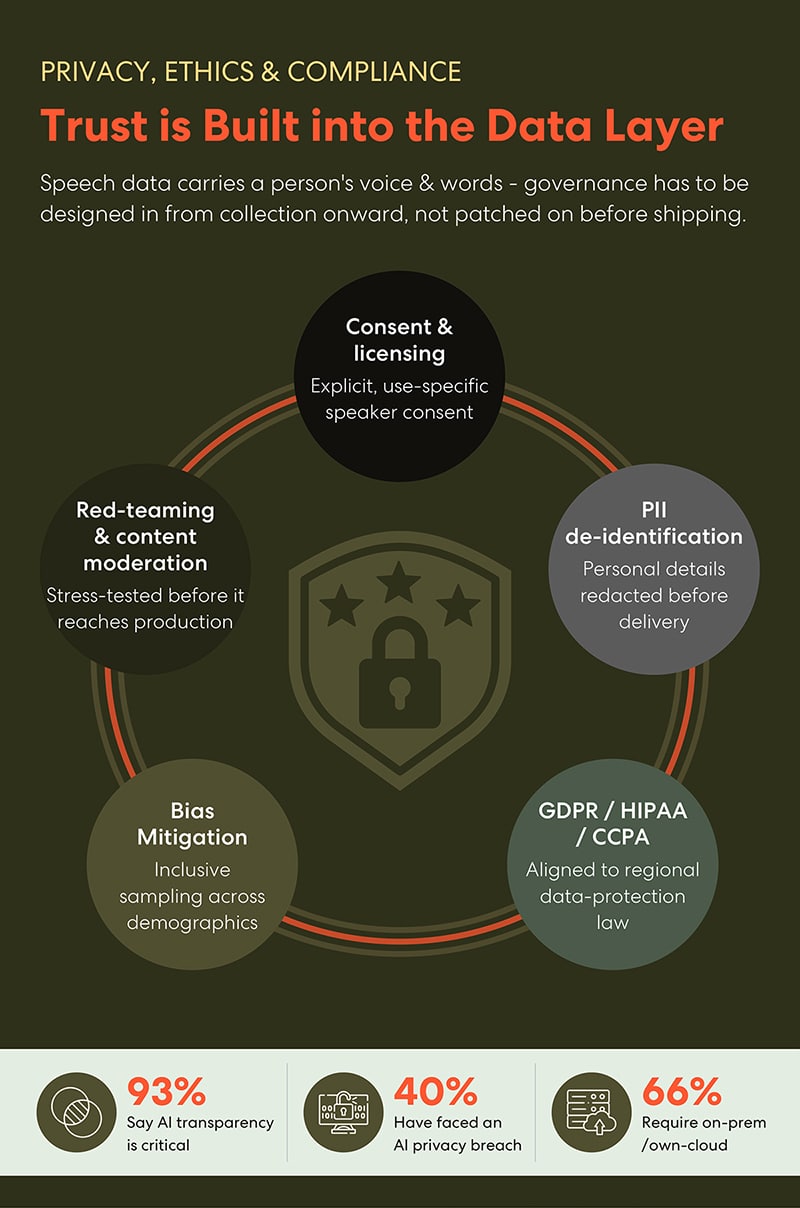
ఐదు నియంత్రణలు రక్షించదగిన డేటా పొరను నిర్వచిస్తాయి.
- సమ్మతి మరియు లైసెన్సింగ్ అంటే స్పష్టమైన, వినియోగానికి నిర్దిష్టమైన వక్త సమ్మతి అని అర్థం — అంతేగానీ, ఇది సాధారణ సేవా నిబంధనల క్లాజు కాదు.
- PII గుర్తింపు తొలగింపు సంఘటన జరిగిన తర్వాత కాకుండా, డెలివరీకి ముందే వ్యక్తిగత వివరాలను తొలగిస్తుంది.
- GDPR, HIPAA మరియు CCPA అనుగుణ్యత ఈ పైప్లైన్ను, వాస్తవానికి ఈ అమలుకు వర్తించే ప్రాంతీయ డేటా-రక్షణ చట్టానికి అనుసంధానిస్తుంది.
- పక్షపాతం తగ్గించడం ఇది అన్ని జనాభా వర్గాలకూ వర్తించే నమూనా సేకరణను, సేకరణ ప్రణాళికలోనే పొందుపరుస్తుంది, దీనికి ఎటువంటి ఖర్చు ఉండదు; అంతేకానీ, ప్రతీదీ ఖర్చయ్యే పునరుద్ధరణలో కాదు.
- మరియు రెడ్-టీమింగ్ మరియు కంటెంట్ మోడరేషన్ ఉత్పత్తి వినియోగదారుల వద్దకు చేరకముందు సిస్టమ్ను ఒత్తిడి పరీక్షలకు గురిచేస్తుంది.
మార్కెట్ దీనిని ఇప్పటికే పరిగణనలోకి తీసుకుంది. 93% సంస్థలు AI పారదర్శకత కీలకమని చెబుతున్నాయి, 40% సంస్థలు ఇప్పటికే AI గోప్యతా ఉల్లంఘనను ఎదుర్కొన్నాయి, మరియు 66% సంస్థలు ఇప్పుడు ఆన్-ప్రిమైజ్ లేదా సొంత-క్లౌడ్ డిప్లాయ్మెంట్ను తప్పనిసరి చేస్తున్నాయి. కొనుగోలుదారులు డేటా ఎక్కడి నుండి వచ్చిందని అడుగుతున్నారు — మరియు రానురాను, వారు ఆ సమాధానాన్ని ఒక ఒప్పందంలో కోరుకుంటున్నారు.
సంభాషణాత్మక AI ఎక్కడ కనిపిస్తుంది
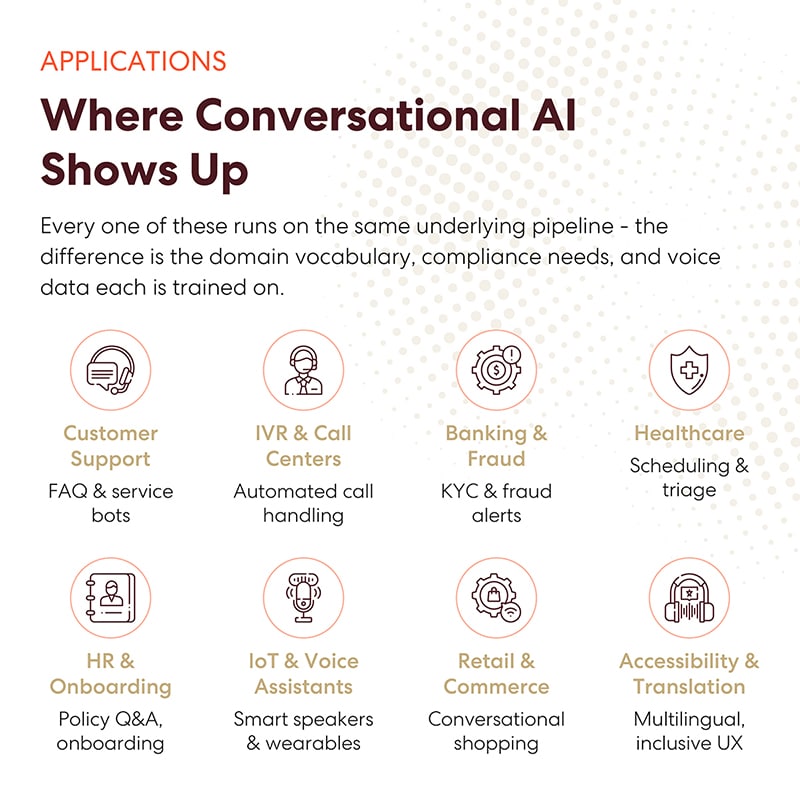
ఎనిమిది అప్లికేషన్ రంగాలు చాలా వరకు ఎంటర్ప్రైజ్ డిప్లాయ్మెంట్కు కారణమవుతాయి.
- వినియోగదారుని మద్దతు FAQ మరియు సర్వీస్ బాట్లను నడుపుతుంది.
- IVR మరియు కాల్ సెంటర్లు కాల్ హ్యాండ్లింగ్ మరియు రూటింగ్ను స్వయంచాలకం చేస్తాయి.
- బ్యాంకింగ్ మరియు మోసం KYC ధృవీకరణ మరియు మోస హెచ్చరికలను కవర్ చేస్తుంది.
- ఆరోగ్య సంరక్షణ షెడ్యూలింగ్ మరియు ట్రయేజ్ను నిర్వహిస్తుంది.
- హెచ్ఆర్ మరియు ఆన్బోర్డింగ్ పాలసీ ప్రశ్నోత్తరాలు మరియు కొత్తగా చేరిన వారి వర్క్ఫ్లోలను నిర్వహిస్తుంది.
- ఐఓటి మరియు వాయిస్ అసిస్టెంట్లు స్మార్ట్ స్పీకర్లు మరియు వేరబుల్స్కు శక్తినివ్వండి.
- రిటైల్ మరియు వాణిజ్యం సంభాషణాత్మక షాపింగ్కు వీలు కల్పిస్తుంది.
- మరియు ప్రాప్యత మరియు అనువాదం ప్రామాణిక ఇంటర్ఫేస్ పరిధిలోకి రాని వ్యక్తులకు బహుభాషా, సమ్మిళిత వినియోగదారు అనుభవాన్ని అందిస్తుంది.
వీటిలో ప్రతి ఒక్కటీ ఒకే అంతర్లీన పైప్లైన్పై నడుస్తుంది. తేడా కేవలం డొమైన్ పదజాలం, అనుగుణ్యత అవసరాలు, మరియు ప్రతిదానికీ శిక్షణ ఇచ్చే వాయిస్ డేటాలోనే ఉంటుంది. ఆ చివరి వేరియబుల్లోనే బృందాలు తక్కువ పెట్టుబడి పెడతాయి మరియు డెమో వెలుపల డిప్లాయ్మెంట్ పనిచేస్తుందా లేదా అని నిర్ధారించేది కూడా అదే.
మెరుగైన సంభాషణాత్మక AI మెరుగైన డేటాతో ప్రారంభమవుతుంది
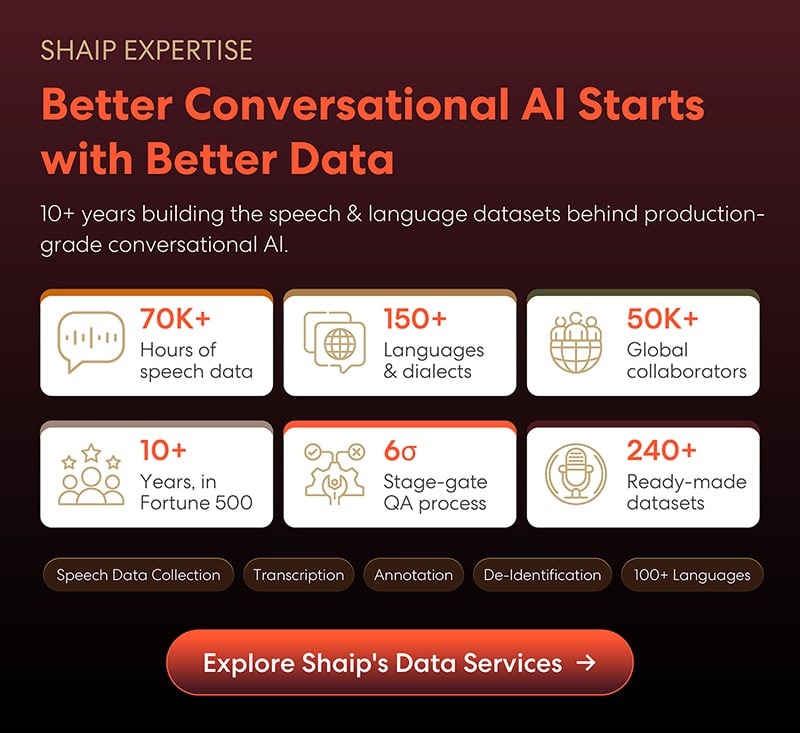
పనిచేసే నమూనాకు మరియు ఉత్పత్తి-స్థాయి సహాయకుడికి మధ్య ఉన్న అంతరాన్ని పూడ్చడం అనేది ఒక డేటా-ఆపరేషన్స్ సమస్య, మరియు దీనిపైనే షాయిప్ ఒక దశాబ్దానికి పైగా గడిపారు:
- 70+ గంటలు ప్రసంగ డేటా యొక్క,
- 150+ భాషలు మరియు మాండలికాలు,
- 50వేలకు పైగా ప్రపంచవ్యాప్త సహకారులు,
- 10 + సంవత్సరాలు ఫార్చ్యూన్ 500 AI బృందాలకు సేవలు అందిస్తోంది,
- a సిక్స్-సిగ్మా స్టేజ్-గేట్ QA ప్రక్రియ,
- 240+ రెడీమేడ్ డేటాసెట్లు మొదటి నుండి సేకరించడానికి కాలపరిమితి అనుమతించనప్పుడు, ఇది సిద్ధంగా అందుబాటులో ఉంటుంది.
స్పీచ్ డేటా సేకరణ, ట్రాన్స్క్రిప్షన్, అనోటేషన్ మరియు డీ-ఐడెంటిఫికేషన్ అన్నింటిలోనూ లక్ష్యం ఒక్కటే: మీ ఉత్పత్తి వాస్తవానికి ఎవరితో మాట్లాడుతుందో ఆ వ్యక్తులను ప్రతిబింబించే శిక్షణా డేటాను పొందడం, దానిని నిరూపించడానికి సమ్మతి పత్రం మరియు నాణ్యతా కొలమానాలను కలిగి ఉండటం.
బాటమ్ లైన్
సంభాషణాత్మక AI ఇకపై సాంకేతిక ప్రశ్నగా మిగలలేదు. దీనిలోని ప్రక్రియ బాగా అర్థమైంది, నమూనాలు విస్తృతంగా అందుబాటులో ఉన్నాయి, మరియు ప్రతి పరిశ్రమ బడ్జెట్లలో దీని అనువర్తనాలు ఒక అంశంగా చేర్చబడ్డాయి. నిజంగా కష్టంగా మిగిలింది డేటా పొర మాత్రమే — దీర్ఘకాలిక కవరేజ్, లేబుల్ ఒప్పందం, జనాభా సమతుల్యత, సమ్మతి, మరియు గుర్తింపును తొలగించడం.
ప్రయోజనం కూడా అక్కడే ఉంది. ఒకే మోడల్ను ఉపయోగించే రెండు బృందాలు చాలా భిన్నమైన నాణ్యత గల ఉత్పత్తులను అందిస్తాయి, మరియు ఆ వ్యత్యాసానికి మూలం వారి సిస్టమ్లకు దేనిపై శిక్షణ ఇచ్చారనేదే. మీరు సంభాషణాత్మక AIని రూపొందిస్తున్నట్లయితే, మీరు తీసుకునే అత్యంత కీలకమైన నిర్ణయాలు ఆర్కిటెక్చర్కు సంబంధించినవి కావు. అవి మీ డేటాసెట్లో ఎవరి స్వరాలు ఉన్నాయి, వాటికి ఎంత బాగా లేబుల్ చేయబడింది, మరియు వాటిని ఉపయోగించే హక్కు మీకు ఉందా లేదా అనే విషయాలకు సంబంధించినవి.