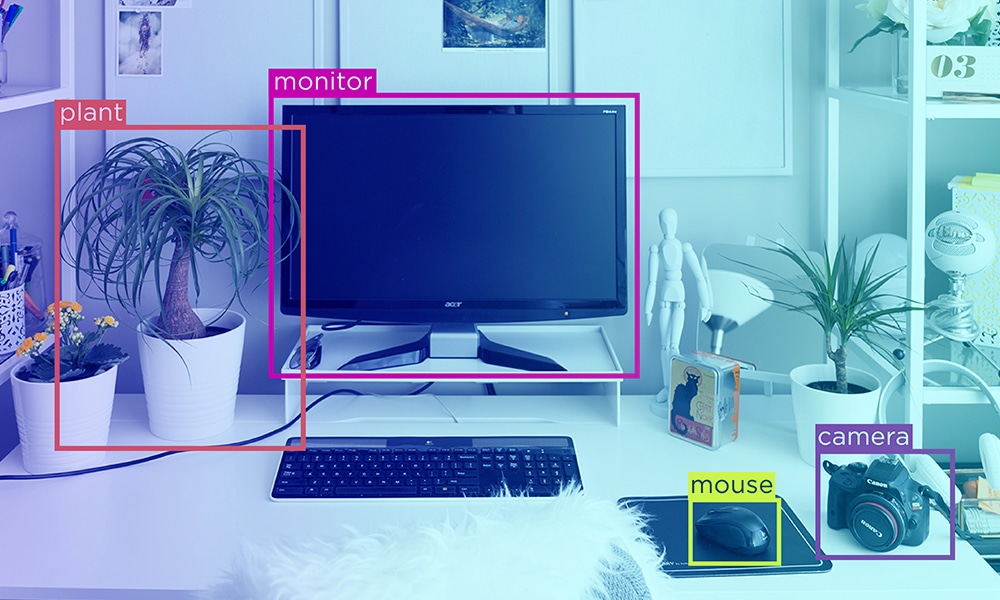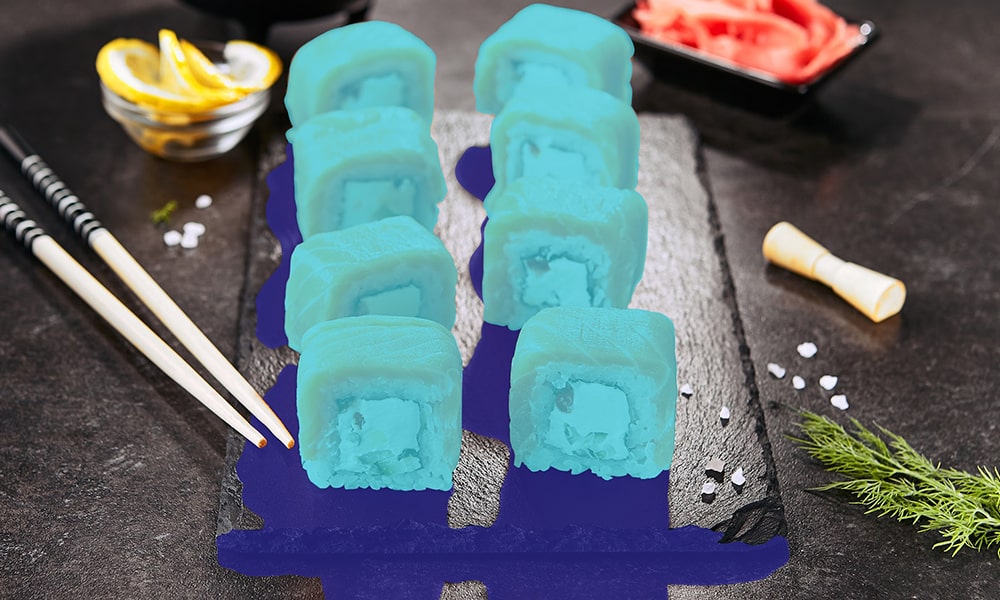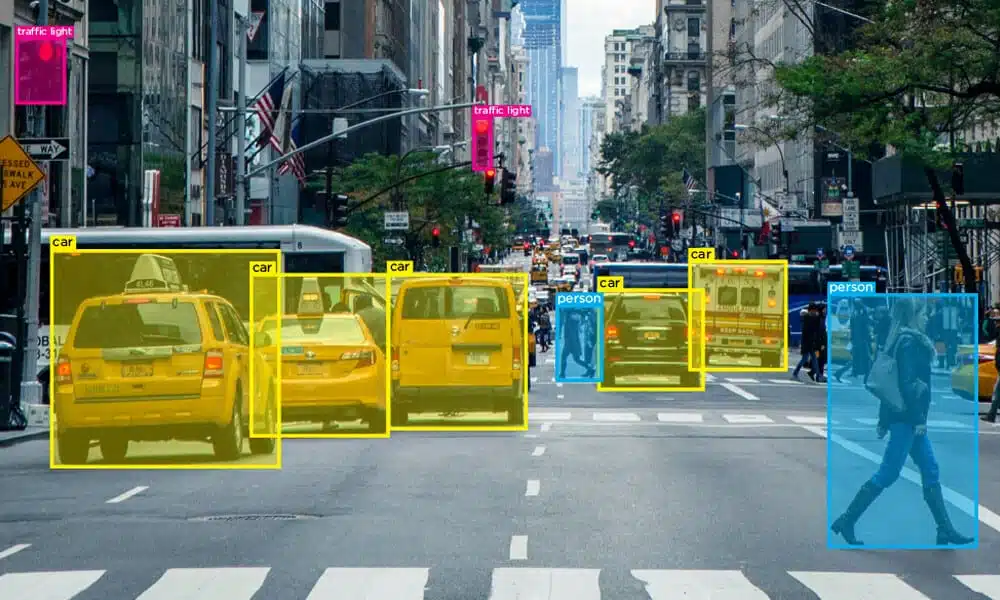
మీకు తెలిసినట్లుగా, డేటా అనొటేషన్ లేదా డేటా లేబులింగ్ అనేది ఒక నిరంతర ప్రక్రియ. మీ AI మాడ్యూల్స్ ఫలితాలను అందించడంలో సంపూర్ణంగా కచ్చితమైనవిగా మరియు వేగవంతమైనవిగా మారినప్పుడు, వాటికి శిక్షణ ఇవ్వడం ఆపివేయాలని చెప్పడానికి ఖచ్చితమైన ఒక్క క్షణం అంటూ ఏదీ ఉండదు.
మీ AI-శక్తితో కూడిన మాడ్యూల్ను ప్రారంభించడం కేవలం ఒక మైలురాయి మాత్రమే అయితే, ఫలితాలు మరియు సామర్థ్యాలను ఆప్టిమైజ్ చేయడానికి AI శిక్షణ నిరంతరంగా లాంచ్ తర్వాత జరుగుతుంది. దీని కారణంగా, సంస్థలు తమ మెషీన్ లెర్నింగ్ మాడ్యూల్స్ కోసం సంబంధిత డేటా యొక్క భారీ వాల్యూమ్లను రూపొందించే ఆందోళనతో బాధపడుతున్నాయి.
అయితే, ఈరోజు మనం చర్చించబోయే సమస్య అది కాదు. డేటాను ఉత్పత్తి చేసే ఈ సమస్యను పరిష్కరించిన తర్వాత తలెత్తే సవాళ్లను మనం అన్వేషించబోతున్నాం . మీకు లెక్కలేనన్ని డేటా ఉత్పత్తి టచ్పాయింట్లు ఉన్నాయని ఊహించుకోండి. ఈ దశలో మీరు ఎదుర్కొనే అత్యంత సమస్యాత్మకమైన సమస్య, ఇంత భారీ పరిమాణంలో ఉన్న డేటాకు వ్యాఖ్యానం జోడించడమే (annotating) .
స్కేలబుల్ డేటా లేబులింగ్ అనేది ఈ రోజు మనం వెలుగులోకి తీసుకురాబోతున్నాం, ఎందుకంటే మేము మాట్లాడిన సంస్థలు మరియు బృందాలు డేటాను రూపొందించడం కంటే మెషిన్ కాన్ఫిడెన్స్ను నిర్మించడం మరింత సవాలుగా ఉన్నాయని ఈ వాటాదారులు కనుగొన్నారు. మరియు మీకు తెలిసినట్లుగా, మెషిన్ కాన్ఫిడెన్స్ అనేది సరిగ్గా ఉల్లేఖించబడిన డేటాతో కూడిన సరైన శిక్షణ పొందిన సిస్టమ్ల ద్వారా మాత్రమే నిర్మించబడుతుంది. కాబట్టి, డేటా లేబులింగ్ ప్రక్రియల సామర్థ్యాన్ని తగ్గించే 5 ప్రధాన ఆందోళనలను చూద్దాం.
డేటా లేబులింగ్ ప్రయత్నాలను పలుచన చేసే 5 వాస్తవ-ప్రపంచ సవాళ్లు
శ్రామిక శక్తి నిర్వహణ

కాబట్టి, సంస్థలు నాణ్యత మరియు పరిమాణం రెండింటినీ సమతుల్యం చేసి, మార్పును తీసుకువచ్చే మరియు ఒక లక్ష్యాన్ని సాధించే ఫలితాలను సాధించాలనే సవాలును ఎదుర్కొంటున్నాయి. ఇటువంటి సందర్భాలలో, మానవ వనరులను నిర్వహించడం అత్యంత కష్టంగా మరియు శ్రమతో కూడుకున్నదిగా మారుతుంది. అవుట్సోర్సింగ్ సహాయపడినప్పటికీ, డేటా అనొటేషన్ ప్రయోజనాల కోసం ప్రత్యేక అంతర్గత బృందాలను కలిగి ఉన్న వ్యాపారాలు ఈ క్రింది అడ్డంకులను ఎదుర్కొంటాయి:
- డేటా లేబులింగ్ కోసం ఉద్యోగుల శిక్షణ
- బృందాల అంతటా పని పంపిణీ మరియు పరస్పర చర్యను పెంపొందించడం
- సూక్ష్మ మరియు స్థూల స్థాయిలలో పనితీరు మరియు పురోగతి ట్రాకింగ్
- అట్రిషన్ను పరిష్కరించడం మరియు కొత్త ఉద్యోగులకు తిరిగి శిక్షణ ఇవ్వడం
- డేటా శాస్త్రవేత్తలు, ఉల్లేఖనాలు మరియు ప్రాజెక్ట్ మేనేజర్ల మధ్య సమన్వయాన్ని క్రమబద్ధీకరించడం
- సాంస్కృతిక, భాష మరియు భౌగోళిక అడ్డంకులను తొలగించడం మరియు కార్యాచరణ పర్యావరణ వ్యవస్థల నుండి పక్షపాతాలను తొలగించడం మరియు మరిన్ని

ఆర్థిక ట్రాకింగ్
AI శిక్షణలో బడ్జెట్ కేటాయింపు అనేది అత్యంత కీలకమైన దశలలో ఒకటి. టెక్ స్టాక్, వనరులు, సిబ్బంది మరియు మరిన్నింటి పరంగా ఒక AI మాడ్యూల్ను నిర్మించడానికి మీరు ఎంత ఖర్చు చేయడానికి సిద్ధంగా ఉన్నారో ఇది నిర్వచిస్తుంది, ఆపై ఖచ్చితమైన పెట్టుబడిపై రాబడి (RoI)ని లెక్కించడంలో మీకు సహాయపడుతుంది. AI వ్యవస్థలను అభివృద్ధి చేసే సాహసం చేసే కంపెనీలలో దాదాపు 26% కంపెనీలు సరైన బడ్జెట్ కేటాయింపు లేకపోవడం వల్ల మధ్యలోనే విఫలమవుతున్నాయి. డబ్బు ఎక్కడికి వెచ్చిస్తున్నారనే దానిపై పారదర్శకత లేదు, అలాగే తమ డబ్బు దేనిగా మారుతుందో వాటాదారులకు నిజ-సమయ అంతర్దృష్టులను అందించే సమర్థవంతమైన కొలమానాలు కూడా లేవు.
చిన్న మరియు మధ్య తరహా సంస్థలు తరచుగా ప్రాజెక్టుకు చెల్లింపు లేదా గంటకు చెల్లింపు అనే సందిగ్ధతలో, అలాగే అనోటేషన్ ప్రయోజనాల కోసం SMEలను నియమించుకోవాలా లేదా మధ్యవర్తుల బృందాన్ని నియమించుకోవాలా అనే లొసుగులో చిక్కుకుపోతుంటాయి . బడ్జెట్ ప్రక్రియ సమయంలో వీటన్నింటినీ తొలగించవచ్చు.
డేటా గోప్యత కట్టుబడి & సమ్మతి
AI కోసం వినియోగ కేసుల సంఖ్య పెరుగుతున్నప్పుడు, వ్యాపారాలు తరంగాలను తొక్కడం మరియు జీవితాన్ని మరియు అనుభవాన్ని మెరుగుపరిచే పరిష్కారాలను అభివృద్ధి చేయడానికి పరుగెత్తుతున్నాయి. స్పెక్ట్రమ్ యొక్క మరొక చివరలో అన్ని పరిమాణాల వ్యాపారాలు శ్రద్ధ వహించాల్సిన సవాలు - డేటా గోప్యతా ఆందోళనలు.
ఇది గోప్యతా ప్రమాణాల సరైన నిర్వహణ మరియు గోప్యమైన డేటా యొక్క సరసమైన వినియోగానికి అనుగుణంగా ఉండవలసిన అవసరాన్ని పెంచుతుంది. సాంకేతికంగా, డేటాను అనధికారికంగా యాక్సెస్ చేయడాన్ని, డేటా-సురక్షిత పర్యావరణ వ్యవస్థలో అనధికార పరికరాలను ఉపయోగించడం, ఫైల్ల అక్రమ డౌన్లోడ్లు, క్లౌడ్ సిస్టమ్లకు బదిలీ చేయడం మరియు మరిన్నింటిని నిరోధించే వ్యాపారాల ద్వారా ధ్వని మరియు సురక్షితమైన పర్యావరణం హామీ ఇవ్వబడాలి. డేటా గోప్యతను నియంత్రించే చట్టాలు క్లిష్టంగా ఉంటాయి మరియు చట్టపరమైన పరిణామాలను నివారించడానికి ప్రతి ఒక్క అవసరాన్ని నిర్ధారించడానికి జాగ్రత్త తీసుకోవాలి.
స్మార్ట్ సాధనాలు & సహాయక ఉల్లేఖనాలు
రెండు విభిన్న రకాల ఉల్లేఖన పద్ధతుల్లో - మాన్యువల్ మరియు ఆటోమేటిక్, హైబ్రిడ్ ఉల్లేఖన నమూనా భవిష్యత్తుకు అనువైనది. ఎందుకంటే AI వ్యవస్థలు భారీ మొత్తంలో డేటాను సజావుగా ప్రాసెస్ చేయడంలో మంచివి మరియు లోపాలను ఎత్తి చూపడంలో మరియు ఫలితాలను ఆప్టిమైజ్ చేయడంలో మానవులు గొప్పగా ఉంటారు.
AI-సహాయక సాధనాలు మరియు ఉల్లేఖన పద్ధతులు ఈ రోజు మనం ఎదుర్కొంటున్న సవాళ్లకు దృఢమైన పరిష్కారాలు, ఎందుకంటే ఇది ప్రక్రియలో పాల్గొన్న అన్ని వాటాదారుల జీవితాలను సులభతరం చేస్తుంది. స్మార్ట్ సాధనాలు వ్యాపారాలు పని అసైన్మెంట్లు, పైప్లైన్ నిర్వహణ, ఉల్లేఖన డేటా నాణ్యత నియంత్రణను ఆటోమేట్ చేయడానికి మరియు మరింత సౌకర్యాన్ని అందించడానికి అనుమతిస్తాయి. స్మార్ట్ సాధనాలు లేకుండా, సిబ్బంది ఇప్పటికీ వాడుకలో లేని సాంకేతికతలపై పని చేస్తారు, పనిని పూర్తి చేయడానికి మానవ గంటలను గణనీయంగా నెట్టివేస్తారు.
డేటా నాణ్యత & పరిమాణంలో స్థిరత్వాన్ని నిర్వహించడం
డేటా నాణ్యతను అంచనా వేయడంలో ముఖ్యమైన అంశాలలో ఒకటి డేటాసెట్లలో లేబుల్ల నిర్వచనాన్ని అంచనా వేయడం. తెలియని వారి కోసం, రెండు ప్రధాన రకాల డేటాసెట్లు ఉన్నాయని అర్థం చేసుకుందాం –
- ఆబ్జెక్టివ్ డేటా – ఎవరు చూసినా నిజమైన లేదా సార్వత్రికమైన డేటా
- మరియు సబ్జెక్టివ్ డేటా – ఎవరు యాక్సెస్ చేస్తారనే దాని ఆధారంగా బహుళ అవగాహనలను కలిగి ఉండే డేటా
ఉదాహరణకు, ఒక ఆపిల్ను ఎర్ర ఆపిల్గా గుర్తించడం నిష్పక్షపాతమైనది, ఎందుకంటే అది సార్వత్రికమైనది. కానీ, చేతిలో సూక్ష్మమైన డేటాసెట్లు ఉన్నప్పుడు విషయాలు సంక్లిష్టంగా మారతాయి. ఒక సమీక్షపై కస్టమర్ ఇచ్చిన చమత్కారమైన స్పందనను పరిగణించండి. ఆ వ్యాఖ్య వ్యంగ్యమా లేక అభినందననా అని అర్థం చేసుకుని, దానికి అనుగుణంగా పేరు పెట్టేంత తెలివి వ్యాఖ్యాతకు ఉండాలి. వ్యాఖ్యాత పెట్టిన పేరు ఆధారంగా సెంటిమెంట్ విశ్లేషణ మాడ్యూల్స్ పనిచేస్తాయి. కాబట్టి, అనేక మంది వ్యక్తులు పనిచేస్తున్నప్పుడు, ఒక బృందం ఏకాభిప్రాయానికి ఎలా వస్తుంది?
వ్యాపారాలు వ్యత్యాసాలను తొలగించే మార్గదర్శకాలు మరియు నియమాలను ఎలా అమలు చేయగలవు మరియు సబ్జెక్టివ్ డేటాసెట్లలో గణనీయమైన నిష్పాక్షికతను తీసుకురాగలవు?

చుట్టి వేయు
డేటా సైంటిస్టులు మరియు అనోటేటర్లు ప్రతిరోజూ ఎదుర్కొనే సవాళ్లు చాలా అధికంగా అనిపిస్తాయి, కదూ? మనం ఇప్పటివరకు చర్చించిన ఆందోళనలు, డేటా నిరంతరం అందుబాటులో ఉండటం వల్ల ఉత్పన్నమయ్యే సవాలులో కేవలం ఒక భాగం మాత్రమే. ఈ పరిధిలో ఇంకా చాలా అంశాలు ఉన్నాయి.
అయినప్పటికీ, డేటా అనొటేషన్లో ప్రక్రియలు మరియు వ్యవస్థల పరిణామం వల్ల మనం వీటన్నింటినీ అధిగమించి ముందుకు సాగుతామని ఆశిస్తున్నాము. అలాగే, మీ అవసరాల ఆధారంగా మీకు అధిక-నాణ్యత గల డేటాను అందించే అవుట్సోర్సింగ్ ( shaip ) ఎంపికలు ఎల్లప్పుడూ అందుబాటులో ఉంటాయి.