ఆప్టికల్ క్యారెక్టర్ రికగ్నిషన్ (OCR) ఇప్పుడు రసీదు స్కానింగ్, ID ధృవీకరణ, ఇన్వాయిస్ ఆటోమేషన్, చారిత్రక ఆర్కైవ్ డిజిటైజేషన్ మరియు స్టైలస్ ఆధారిత నోట్ యాప్లకు శక్తినిస్తుంది. OCR మార్కెట్ 2030 నాటికి 14.8% CAGR (గ్రాండ్ వ్యూ రీసెర్చ్, 2024)తో $32.90 బిలియన్లకు చేరుకుంటుందని అంచనా వేయబడింది, ఇందులో OCR యొక్క చేతిరాతను చదివే విభాగమైన ఇంటెలిజెంట్ క్యారెక్టర్ రికగ్నిషన్ అత్యంత వేగంగా అభివృద్ధి చెందుతోంది. మీరు డాక్యుమెంట్ పార్సింగ్, సీన్-టెక్స్ట్ డిటెక్షన్ లేదా చేతిరాత ట్రాన్స్క్రిప్షన్ నిర్మిస్తున్నా, మీరు శిక్షణ ఇచ్చే OCR డేటాసెట్ మీ కచ్చితత్వ పరిమితిని నిర్దేశిస్తుంది. ఈ గైడ్ 22 ఉచిత, ఓపెన్-సోర్స్ OCR డేటాసెట్లను — ఉత్తమ చేతిరాత డేటాసెట్లతో సహా — వినియోగ సందర్భాల వారీగా వర్గీకరించి, 2024 వరకు అత్యంత శక్తివంతమైన విడుదలలతో అప్డేట్ చేస్తుంది.
కీ టేకావేస్
- OCR (ఆప్టికల్ క్యారెక్టర్ రికగ్నిషన్): ముద్రిత, దృశ్య లేదా చేతివ్రాత వచన చిత్రాలను యంత్రం చదవగలిగే డేటాగా మార్చే సాంకేతికత.
- OCR డేటాసెట్లు ఐదు సమూహాలుగా విభజించబడ్డాయి: పత్రం/ఫారం, దృశ్య వచనం, అంకె/అక్షరం, చేతిరాత మరియు బహుభాషా.
- డాక్యుమెంట్ OCR డేటాసెట్లు ఫారమ్లు మరియు రసీదుల వంటి క్రమబద్ధమైన పేజీలను సంగ్రహించండి; దృశ్య-వచన డేటాసెట్లు సహజ వాతావరణంలో టెక్స్ట్ను సంగ్రహించండి.
- పరిశోధన రంగంలో IAM, MNIST, ICDAR మరియు SROIE అత్యధికంగా ఉదహరించబడిన OCR ప్రమాణాలుగా నిలిచాయి.
- లైసెన్స్ నిబంధనలు చాలా విభిన్నంగా ఉంటాయి — వాణిజ్య శిక్షణకు ముందు ప్రతి OCR డేటాసెట్ను సరిచూసుకోండి.
OCR (ఆప్టికల్ క్యారెక్టర్ రికగ్నిషన్) అంటే ఏమిటి?
OCR అనేది స్కాన్ చేసిన పేపర్ డాక్యుమెంట్లు, PDFలు లేదా టెక్స్ట్ యొక్క ఇమేజ్లు వంటి వివిధ రకాల డాక్యుమెంట్లను సవరించగలిగే మరియు శోధించదగిన డేటాగా మార్చే సాంకేతికత. ఇది దీని ద్వారా పనిచేస్తుంది:
- చిత్రంలో టెక్స్ట్ యొక్క నిర్మాణాన్ని విశ్లేషించడం
- వచనాన్ని పంక్తులు మరియు అక్షరాలుగా విభజించడం
- ఈ దృశ్య అక్షరాలను మెషిన్-రీడబుల్ టెక్స్ట్గా మారుస్తోంది
సాధారణ ఉపయోగాలు:
- స్కాన్ చేసిన పత్రాలను సవరించగలిగే టెక్స్ట్ ఫైల్లుగా మారుస్తోంది
- ముద్రిత పుస్తకాలను డిజిటలైజ్ చేయడం
- ఫోటోల నుండి వచనాన్ని సంగ్రహించడం
- చేతితో రాసిన ప్రిస్క్రిప్షన్లను డిజిటల్ టెక్స్ట్గా మారుస్తోంది
- లైసెన్స్ ప్లేట్ గుర్తింపు
మీరు సరైన OCR డేటాసెట్ను ఎలా ఎంచుకుంటారు?
OCR డేటాసెట్ను ఎంచుకోవడం నాలుగు అంశాలపై ఆధారపడి ఉంటుంది: టెక్స్ట్ రకం, క్యాప్చర్ వాతావరణం, అనోటేషన్ గ్రాన్యులారిటీ మరియు లైసెన్స్. చేతిరాత కర్సివ్ లేదా వక్ర దృశ్య టెక్స్ట్ కంటే ప్రింటెడ్-డాక్యుమెంట్ OCRకు భిన్నమైన శిక్షణా డేటా అవసరం. డాక్యుమెంట్ డేటాసెట్లు ఇన్వాయిస్లు, ఫారమ్లు మరియు రసీదులకు సరిపోతాయి; దృశ్య-టెక్స్ట్ డేటాసెట్లు సైనేజ్ మరియు ఉత్పత్తి పఠనానికి సరిపోతాయి; చేతిరాత డేటాసెట్లు నోట్స్, మాన్యుస్క్రిప్ట్లు మరియు స్టైలస్ ఇన్పుట్కు సరిపోతాయి. పద-స్థాయి మరియు లైన్-స్థాయి అనోటేషన్లు పూర్తి OCR పైప్లైన్లకు మద్దతు ఇస్తాయి, అయితే అక్షర-స్థాయి సెట్లు వర్గీకరణ బేస్లైన్లకు సరిపోతాయి. కొన్ని OCR డేటాసెట్లు కేవలం పరిశోధన కోసం మాత్రమే లేదా రిజిస్ట్రేషన్ అవసరం కాబట్టి, లైసెన్స్ నిబంధనలను ఎల్లప్పుడూ నిర్ధారించుకోండి.
అత్యుత్తమ డాక్యుమెంట్ మరియు ఫారం OCR డేటాసెట్లు ఏవి?
డాక్యుమెంట్ OCR డేటాసెట్లు ఇన్వాయిస్లు, ఫారమ్లు, రసీదులు మరియు IDల వంటి నిర్మాణాత్మక పేజీలను పార్స్ చేయడానికి మోడల్లకు శిక్షణ ఇస్తాయి. ఇవి వ్యాపార డాక్యుమెంట్ ఆటోమేషన్ మరియు కీ-వాల్యూ ఎక్స్ట్రాక్షన్కు శక్తినిస్తాయి.
- FUNSD — వాస్తవ ప్రపంచంలో కనిపించే అస్పష్టమైన స్వరూపంతో, వివరణలతో కూడిన 199 స్కాన్ చేసిన ఫారాలు. ఫారాలను అర్థం చేసుకోవడానికి మరియు కీలక విలువలను సంగ్రహించడానికి ఇది ఒక ప్రామాణిక కొలమానం.
- SROIE — ICDAR 2019 స్కాన్ చేసిన రసీదుల డేటాసెట్, సుమారు 1,000 రసీదులు, ఒకే సెట్లో టెక్స్ట్ గుర్తింపు, గుర్తించడం మరియు సమాచార సంగ్రహణకు మద్దతు ఇస్తుంది.
- కార్డ్ — OCR అనంతర పార్సింగ్ కోసం రూపొందించబడిన ఒక ఏకీకృత రసీదు డేటాసెట్, ఇది ఇన్వాయిస్ మరియు రసీదు ఆటోమేషన్ కోసం సమగ్రమైన ఫీల్డ్-స్థాయి లేబుల్లను కలిగి ఉంటుంది.
- XFUND — FUNSD యొక్క బహుభాషా విస్తరణ, ఇది ఏడు భాషలను (జర్మన్, స్పానిష్, ఫ్రెంచ్, ఇటాలియన్, జపనీస్, పోర్చుగీస్, చైనీస్) కవర్ చేస్తుంది మరియు ప్రతి భాషలో 199 పేజీలు ఉంటాయి. బహుభాషా డాక్యుమెంట్ AIకి ఇది చాలా అనువైనది.
- డిడిఐ-100 వక్రత, అస్పష్టత మరియు శబ్దం వంటి వాస్తవ ప్రపంచ క్షీణత పరిస్థితులలో గుర్తించడం మరియు గుర్తించడం కోసం సుమారు 100,000 వక్రీకరించిన డాక్యుమెంట్ చిత్రాలు.
అత్యుత్తమ సీన్ టెక్స్ట్ OCR డేటాసెట్లు ఏవి?
సైన్బోర్డులు, ఉత్పత్తులు, మరియు వీధి దృశ్యాలు వంటి సహజ చిత్రాలలోని టెక్స్ట్ను చదవడానికి సీన్-టెక్స్ట్ OCR డేటాసెట్లు మోడల్లకు శిక్షణ ఇస్తాయి. నేపథ్యాలు గజిబిజిగా ఉండే ఇన్-ది-వైల్డ్ OCRకు ఇవి చాలా అవసరం.
- ICDAR పటిష్టమైన పఠనం — పద-స్థాయి బౌండింగ్ బాక్స్లు మరియు ట్రాన్స్క్రిప్షన్లతో కూడిన ఫోకస్డ్ మరియు ఇన్సిడెంటల్ సీన్ టెక్స్ట్ ఛాలెంజ్లతో సహా, చాలా సీన్-టెక్స్ట్ పరిశోధనల వెనుక ఉన్న ప్రామాణిక కుటుంబం.
- కోకో-టెక్స్ట్ — MS-COCO చిత్రాలపై పొరలుగా అమర్చబడిన భారీ-స్థాయి దృశ్య-వచన ఉల్లేఖనాలు. సహజ దృశ్యాలలో పెద్ద స్థాయిలో వచనాన్ని గుర్తించడానికి శక్తివంతమైనవి.
- మొత్తం-వచనం — వక్రంగా మరియు ఏటవాలుగా ఉన్న అక్షరాలను గుర్తించడంలో ప్రత్యేకత కలిగి ఉంది, ఇది పాత OCR మోడళ్లకు తెలిసిన బలహీనత.
- SVT (స్ట్రీట్ వ్యూ టెక్స్ట్) — గూగుల్ స్ట్రీట్ వ్యూ నుండి సేకరించిన పద చిత్రాలు, తరచుగా తక్కువ రిజల్యూషన్ మరియు అధిక వైవిధ్యంతో ఉంటాయి. పేపర్స్ విత్ కోడ్ మిర్రర్స్ ద్వారా అందుబాటులో ఉన్నాయి.
- HierText — చేతిరాత మరియు ముద్రిత దృశ్య వచనం రెండింటినీ కవర్ చేస్తూ, పేరా నుండి పంక్తికి, పంక్తి నుండి పదానికి క్రమానుగత వ్యాఖ్యానం. లేఅవుట్ను పరిగణనలోకి తీసుకునే OCRకు ఉపయోగపడుతుంది.
అత్యుత్తమ అంకె మరియు అక్షర OCR డేటాసెట్లు ఏవి?
అంకె మరియు అక్షర OCR డేటాసెట్లు నియంత్రిత పరిస్థితులలో వ్యక్తిగత చిహ్నాలను గుర్తించడానికి మోడళ్లకు శిక్షణ ఇస్తాయి. ఇవి వర్గీకరణ బేస్లైన్లకు ప్రామాణిక ప్రారంభ స్థానాలు.
- MNIST — 70,000 గ్రేస్కేల్ చేతిరాత అంకెల చిత్రాలు. అంకె వర్గీకరణను ధృవీకరించడానికి అత్యంత వేగవంతమైన బేస్లైన్.
- ఎమ్నిస్ట్ — NIST స్పెషల్ డేటాబేస్ 19 నుండి తీసుకోబడిన 814,255 చేతివ్రాత అక్షరాలు మరియు అంకెలతో MNISTను విస్తరిస్తుంది.
- SVHN (వీధి వీక్షణ ఇంటి నంబర్లు) — ఇంటి నంబర్ల నుండి 600,000కు పైగా వాస్తవ ప్రపంచ అంకెల చిత్రాలు. శబ్దంతో కూడిన పరిస్థితులలో MNIST కంటే ఇది ఒక ఆచరణాత్మకమైన ముందడుగు.
- చార్స్74కె సహజ చిత్రాలు మరియు కంప్యూటర్ ఫాంట్ల నుండి ఆంగ్ల మరియు కన్నడ అక్షరాలను కలిగి ఉన్న 74,107 చిత్రాలు.
- NIST ప్రత్యేక డేటాబేస్ 19 — 3,600 మంది రచయితల నుండి 810,000కు పైగా చేతివ్రాత అక్షర చిత్రాలు. అనేక ఇంగ్లీష్ OCR బెంచ్మార్క్లు దీని నుండే ఉద్భవించాయి.
OCR కోసం ఉత్తమమైన చేతిరాత డేటాసెట్లు ఏవి?
చేతిరాత డేటాసెట్లు కర్సివ్, ప్రింటెడ్ మరియు చారిత్రక చేతిరాత వచనాన్ని చదవడానికి OCR మోడల్లకు శిక్షణ ఇస్తాయి. అత్యంత శక్తివంతమైన ఓపెన్ హ్యాండ్రైటింగ్ డేటాసెట్లు చేతిరాత వచన గుర్తింపు (HTR) కోసం అత్యధికంగా ఉదహరించబడిన బెంచ్మార్క్లుగా మిగిలి ఉన్నాయి.
- IAM చేతివ్రాత డేటాబేస్ — 657 మంది రచయితల నుండి 13,353 టెక్స్ట్ లైన్లతో కూడిన ఆంగ్ల చేతిరాత స్వర్ణ ప్రమాణం. 2024–2025 OCR పరిశోధనలో ఇప్పటికీ అత్యధికంగా ఉదహరించబడిన చేతిరాత డేటాసెట్.
- IAM-OnDB — IAM యొక్క ఆన్లైన్ పెన్-స్ట్రోక్ వెర్షన్, ఇది పథం డేటాను సంగ్రహిస్తుంది. స్టైలస్ మరియు టాబ్లెట్ గుర్తింపు కోసం ప్రామాణిక చేతివ్రాత డేటాసెట్.
- బెంథమ్ పేపర్స్ — తత్వవేత్త జెరెమీ బెంతమ్ రచించిన చారిత్రక ఆంగ్ల చేతివ్రాతల లిప్యంతరీకరణ. చారిత్రక చేతివ్రాత OCR కోసం అగ్రగామి ప్రమాణం, ఇది ట్రాన్స్క్రిబస్ ద్వారా అందుబాటులో ఉంది.
- GNHK (గుడ్నోట్స్ హ్యాండ్రైటింగ్ కలెక్షన్) — 2021 నాటి, ఎలాంటి పరిమితులు లేని వాస్తవ ప్రపంచ ఆంగ్ల చేతివ్రాత నోట్ల డేటాసెట్. ఇది ల్యాబ్లో శుభ్రంగా ఉండే IAM కంటే, చిందరవందరగా ఉండే ప్రొడక్షన్ డేటాకు దగ్గరగా ఉంటుంది.
అత్యుత్తమ బహుభాషా మరియు లాటిన్-యేతర OCR డేటాసెట్లు ఏవి?
బహుభాషా OCR డేటాసెట్లు ఇంగ్లీషుతో పాటు చైనీస్, అరబిక్ మరియు గణిత సంకేతాలతో సహా ఇతర లిపులపై మోడళ్లకు శిక్షణ ఇస్తాయి. ప్రపంచవ్యాప్త డాక్యుమెంట్ మరియు చేతిరాత గుర్తింపునకు ఇవి చాలా అవసరం.
- కాసియా-హెచ్డబ్ల్యూడిబి — 1,020 మంది రచయితల నుండి 1.17 మిలియన్ల చేతివ్రాత అక్షర నమూనాలతో కూడిన ప్రామాణిక చైనీస్ OCR బెంచ్మార్క్.
- ఖట్ — 1,000 మంది విభిన్న రచయితల నుండి 1,000 అరబిక్ చేతివ్రాత ఫారమ్లు, బహుళ రిజల్యూషన్లలో స్కాన్ చేయబడ్డాయి. అత్యంత సమగ్రమైన ఓపెన్ అరబిక్ OCR డేటాసెట్.
- క్రోమ్ — ఆన్లైన్ చేతివ్రాత గణిత వ్యక్తీకరణల గుర్తింపుపై పోటీ: ఆన్లైన్ మరియు ఆఫ్లైన్ రెండు రూపాల్లో, 101కి పైగా గణిత చిహ్నాలపై 10,000కి పైగా వ్యక్తీకరణలు. చేతివ్రాత సమీకరణాల OCRకు ఇది అత్యవసరం.
ఉచిత OCR డేటాసెట్లను ఉపయోగించేటప్పుడు ఎదురయ్యే సాధారణ ఇబ్బందులు ఏమిటి?
చాలా జట్లను మూడు ఆపదలు పట్టుకుంటాయి.
డొమైన్ సరిపోలకపోవడం: శుభ్రమైన IAM లేదా COCO-Text పై శిక్షణ ఇచ్చి, నలిగిపోయిన ఇన్వాయిస్లపై అమలు చేయడం వలన కచ్చితత్వం తక్కువగా ఉంటుందని హామీ ఇస్తుంది.
లైసెన్స్ అజ్ఞానం: అనేక దృశ్య-పాఠ్య మరియు చారిత్రక OCR డేటాసెట్లు కేవలం పరిశోధన కోసం మాత్రమే లేదా వాణిజ్యపరమైన ఉపయోగం కోసం ముందు నమోదు చేసుకోవాలి.
అనోటేషన్ లోపాలు: అనేక OCR డేటాసెట్లలో ప్రొడక్షన్ సిస్టమ్లకు అవసరమైన లేఅవుట్ మెటాడేటా, లైన్-స్థాయి బౌండింగ్ బాక్స్లు లేదా ఫీల్డ్ లేబుల్లు ఉండవు.
షిప్పింగ్ లేబుల్లను చదివే ప్రక్రియను ఆటోమేట్ చేస్తున్న ఒక మధ్యస్థాయి లాజిస్టిక్స్ సంస్థను ఊహించుకోండి. పబ్లిక్ సీన్-టెక్స్ట్ శిక్షణ వారిని బెంచ్మార్క్లలో 80%కి చేర్చింది, కానీ మెరుపు మరియు మడతలతో కూడిన నిజమైన లేబుల్స్ వారి పనితీరును 58%కి తగ్గించాయి. ఆ అంతరాన్ని పూడ్చడానికి, ప్రారంభానికి ముందు 6,000 ఇన్-డొమైన్ లేబుల్ చిత్రాలకు లక్షిత డేటా అనొటేషన్ అవసరమైంది.
ఓపెన్ సోర్స్ డేటాసెట్ల ప్రయోజనాలు మరియు సవాళ్లు
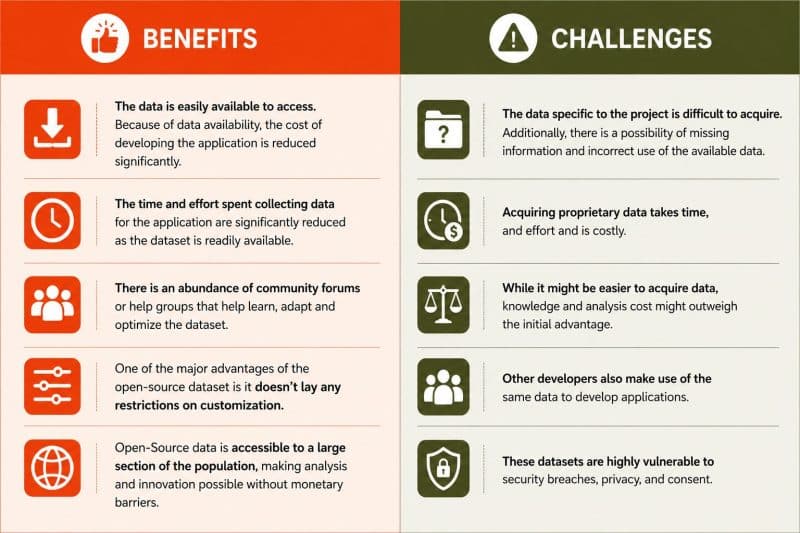
వ్యాపారాలు తమ ML అప్లికేషన్ల కోసం ఉచితంగా ఉపయోగించగల డేటాను ఎంచుకోవాలా వద్దా అని అర్థం చేసుకోవడానికి ఒకదానికొకటి ప్రయోజనాలు మరియు సవాళ్లను ఎదుర్కోవాలి.
ప్రయోజనాలు
- డేటా సులభంగా యాక్సెస్ చేయడానికి అందుబాటులో ఉంటుంది. డేటా లభ్యత కారణంగా, అప్లికేషన్ను అభివృద్ధి చేయడానికి అయ్యే ఖర్చు గణనీయంగా తగ్గింది.
- డేటాసెట్ తక్షణమే అందుబాటులో ఉన్నందున అప్లికేషన్ కోసం డేటాను సేకరించడానికి వెచ్చించే సమయం మరియు శ్రమ గణనీయంగా తగ్గుతుంది.
- డేటాసెట్ను నేర్చుకోవడంలో, స్వీకరించడంలో మరియు ఆప్టిమైజ్ చేయడంలో సహాయపడే కమ్యూనిటీ ఫోరమ్లు లేదా సహాయ సమూహాలు పుష్కలంగా ఉన్నాయి.
- ఓపెన్ సోర్స్ డేటాసెట్ యొక్క ప్రధాన ప్రయోజనాల్లో ఒకటి, ఇది అనుకూలీకరణపై ఎటువంటి పరిమితులను విధించదు.
- ఓపెన్-సోర్స్ డేటా జనాభాలోని పెద్ద విభాగానికి అందుబాటులో ఉంటుంది, ద్రవ్యపరమైన అడ్డంకులు లేకుండా విశ్లేషణ మరియు ఆవిష్కరణ సాధ్యమవుతుంది.
సవాళ్లు
- ప్రాజెక్ట్కు సంబంధించిన నిర్దిష్ట డేటాను పొందడం కష్టం. అదనంగా, సమాచారాన్ని కోల్పోయే అవకాశం మరియు అందుబాటులో ఉన్న డేటా యొక్క తప్పు ఉపయోగం.
- యాజమాన్య డేటాను పొందడం సమయం మరియు కృషి మరియు ఖర్చుతో కూడుకున్నది
- డేటాను పొందడం సులభం అయితే, జ్ఞానం మరియు విశ్లేషణ ఖర్చు ప్రారంభ ప్రయోజనం కంటే ఎక్కువగా ఉండవచ్చు.
- అప్లికేషన్లను అభివృద్ధి చేయడానికి ఇతర డెవలపర్లు కూడా అదే డేటాను ఉపయోగిస్తున్నారు.
- ఈ డేటాసెట్లు భద్రతా ఉల్లంఘనలు, గోప్యత మరియు సమ్మతికి చాలా హాని కలిగిస్తాయి.
Shaip, OCR మరియు చేతిరాత గుర్తింపు ప్రాజెక్ట్లకు ఎలా మద్దతు ఇస్తుంది?
Shaip యొక్క OCR శిక్షణ డేటా సేవలు , 60కి పైగా భాషలలో ముద్రిత పత్రాలు, చేతిరాత, రసీదులు మరియు IDలతో సహా , ఓపెన్-డేటాసెట్ క్యూరేషన్ను కస్టమ్ డేటా సేకరణతో జత చేస్తాయి. Shaip యొక్క అనోటేషన్ వర్క్ఫ్లోలు పబ్లిక్ OCR డేటాసెట్లలో లోపించిన పొరలను జోడిస్తాయి: లైన్-స్థాయి బౌండింగ్ బాక్స్లు, ఫీల్డ్-స్థాయి లేబుల్లు, ట్రాన్స్క్రిప్షన్ QC మరియు రచయిత మెటాడేటా.
ముగింపు
పైన ఉన్న 22 OCR డేటాసెట్లు 2026 నాటికి డాక్యుమెంట్, సీన్ టెక్స్ట్, అంకెలు, చేతిరాత మరియు బహుభాషా గుర్తింపు వంటి వాటిలో మీకు పూర్తి ఓపెన్-సోర్స్ పునాదిని అందిస్తాయి. మీ టెక్స్ట్ రకం మరియు క్యాప్చర్ వాతావరణానికి సరిపోయే OCR డేటాసెట్తో ప్రారంభించండి, మీ నిజమైన డేటా యొక్క వేరుగా ఉంచిన నమూనాతో దాన్ని ధృవీకరించండి, మరియు డొమైన్ అంతరాన్ని పూరించడానికి కస్టమ్ అనోటేషన్ కోసం బడ్జెట్ కేటాయించండి. ఈ కలయిక, మొదటి నుండి నిర్మించడం కంటే వేగంగా అందుబాటులోకి వస్తుంది.